


#русский язык
Слушатели узнают, почему ребенок не осваивает родной язык «сам» и можно ли учить иностранный «как дети».

Еще в 1997 году лингвисты предположили, что русской речи свойствен особый максимализм — склонность все преувеличивать, говорить либо «все отлично», либо «все ужасно». Сегодня профессор Новгородского государственного университета Татьяна Шмелева подтвердила эту гипотезу на новом материале — интернет-комментариях к музыкальным и политическим стримам. В них она обнаружила почти четыре десятка аугментативов — увеличительно-усилительных форм слов, которые «возводят оценку в квадрат»: например, домище, ручища, большущий. Это не просто сленг, считает ученый, а проявление прагматической установки новой разговорной речи на максимализм.
Участники смогут выполнить упражнения в старинных прописях и научиться письму чернилами перьевыми ручками.

Слушатели узнают, как внешне традиционная русская культура XVI–XVII веков менее чем за несколько десятилетий превратилась в культуру Нового времени.

Возьмите два вымышленных слова: «буола» и «кикета». Какое из них, по-вашему, обозначает круглое мыло, а какое — острый механизм? 86% опрошенных дали одинаковый ответ. В этом и заключается феномен звукосимволизма: наш мозг связывает сигналы, воспринимаемые в разной модальности (слух, зрение, осязание, вкус), с определенными звуками речи. Раньше этим явлением занимались в основном зарубежные лингвисты. Ученые Пермского Политеха решили восполнить этот пробел и провели масштабное исследование на русском материале. Результаты исследования помогут маркетологам создавать названия, которые подсознательно нравятся покупателям, разработчикам — обучать голосовых помощников естественнее понимать русскую речь, а психологам и логопедам — точнее диагностировать нарушения восприятия.
Исследователи НИУ ВШЭ учат большие языковые модели понимать русскоязычную научную терминологию, увеличивая при этом их энергоэффективность. Адаптированная модель работает в 2,7 раза быстрее и требует на 73% меньше памяти, чем исходная открытая модель, что позволяет запускать ее на более доступном оборудовании.
Слушатели узнают, к каким источникам стоит обращаться, чтобы точно знать, как правильно писать и говорить по-русски сегодня.
Психолингвисты Центра языка и мозга НИУ ВШЭ в Санкт-Петербурге показали, что слова, которые часто пишутся с ошибками, обрабатываются медленнее, даже если написаны правильно. Исследователи впервые подтвердили этот эффект на материале русского языка, а также выяснили, что скорость реакции сильнее всего связана с тем, насколько уверенно люди отличают правильное написание слова от неправильного.
Слушатели узнают, как сто лет назад реформировали существующие письменности и создавали новые для языков народов СССР.
Слушатели узнают, какие аспекты русской культуры и быта оставили свой лингвистический след в языках соседей.

Слушатели узнают о традиционных исследованиях грамматики, о сохранении малых языков, и даже о словах года в разных языках.
Слушатели узнают о феминитивах как об интересном языковом явлении, рассмотрит их «за» и «против» с точки зрения лингвистики.
Международная команда с участием исследователей ФКН НИУ ВШЭ представила KoWit-24 — корпус из 2700 заголовков одного из русскоязычных СМИ с игрой слов. Корпус позволил оценить, как искусственный интеллект распознает и объясняет языковую игру. Эксперименты с пятью большими языковыми моделями подтвердили: даже передовые системы пока ошибаются, причем интерпретация игры слов является для них более сложной задачей, чем ее выявление.

Более трети населения всего мира — носители десяти самых популярных языков. На инфографике наглядно показано, какие языки были наиболее распространены в 1996, а какие стали самыми популярными в 2025.


Команда исследователей из SberAI, НИУ ВШЭ, Института искусственного интеллекта AIRI и МФТИ представила LIBRA — первый в своем роде масштабный бенчмарк для оценки способности больших языковых моделей (LLM) работать с длинными текстами на русском языке. Эта разработка решает критическую проблему в области развития искусственного интеллекта, предоставляя российскому научному сообществу универсальный и прозрачный инструмент для измерения и сравнения производительности нейросетей в одной из самых сложных и востребованных задач.


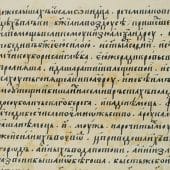
Участники изучат особенности древнерусской письменности, изменявшейся на протяжении многих столетий.
Россияне стали чаще ругаться матом. Каждый третий житель России использует нецензурные выражения хотя бы раз в день.
Доктор филологических наук Александр Летучий обсудит вопросы, связанные со строением предложения в русском языке.
Слушатели узнают о новом законодательстве, связанном с русским языком, о новых словарях и о некоторых вариантах нормы, которые из нежелательных стали допустимыми.
Слушатели узнают, как сегодня работают над словарями и чем современные цифровые ресурсы отличаются от печатных изданий.
Слушатели узнают, как в русском языке появляются новые слова, а также как изменяются значения старых.
Ученые международного проекта MECO, включая специалистов Центра языка и мозга НИУ ВШЭ, разработали инструмент для изучения чтения на английском у носителей более чем 19 языков. В масштабном эксперименте с участием более 1200 человек ученые отслеживали движения глаз во время чтения одних и тех же текстов на английском языке, а затем анализировали уровень понимания. Результаты показали: даже при одинаковом понимании процесс чтения — где взгляд задерживается, куда возвращается, какие слова пропускает — зависит от родного языка и уровня владения английским.
Лингвисты КамГУ имени Витуса Беринга и Дальневосточного федерального университета проанализировали новые жанры языковых публикаций в социальных сетях и выяснили значительные изменения в подходах к языковому просвещению. Традиционные научно-популярные статьи уступили место коротким форматам, интерактивным тестам и даже мемам с лингвистическим содержанием.
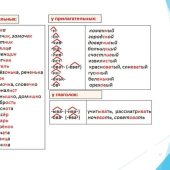
Исследователи ВШЭ выделили более 4000 примеров устной русской речи билингвов из семи регионов России и выяснили: большинство нестандартных форм в конструкциях с числительными связано не только с их родным языком, но и с тем, как часто выражение встречается в повседневной речи. Например, фразы «два часа» или «пять километров» почти всегда совпадают с литературным вариантом, а вот менее привычные выражения, особенно с числительными от двух до четырех, а также с собирательными формами вроде «двое» или «трое», часто звучат иначе.
Центр языка и мозга НИУ ВШЭ разработал первый стандартизированный инструмент для оценки навыков чтения на русском языке у взрослых — тест «ЛексиМетр-В». Теперь он доступен в цифровом формате на платформе RuStore. Это приложение позволяет быстро и эффективно диагностировать нарушения чтения, включая дислексию, у людей в возрасте от 18 лет и старше.

Вы попытались написать запрещенную фразу или вас забанили за частые нарушения.
Понятно
Что-то в вашем комментарии показалось подозрительным, поэтому перед публикацией он пройдет модерацию.
Понятно
Из-за нарушений правил сайта на ваш аккаунт были наложены ограничения. Если это ошибка, напишите нам.
Понятно
Наши фильтры обнаружили в ваших действиях признаки накрутки. Отдохните немного и вернитесь к нам позже.
Понятно


Мы скоро изучим заявку и свяжемся с Вами по указанной почте в случае положительного исхода. Спасибо за интерес к проекту.
Понятно
Последние комментарии