


Инженеры Google описали ключевой изъян машинного обучения, приводящий к ошибкам ИИ
Тема искусственного интеллекта в последние годы стала невероятно популярной. Однако, несмотря на все достижения в этой области, ИИ по-прежнему чаще человека ошибается практически в любом классе задач. Специалисты Google сформулировали один из ключевых недостатков важнейшего компонента создания искусственного интеллекта — машинного обучения — и предложили способ его компенсации.
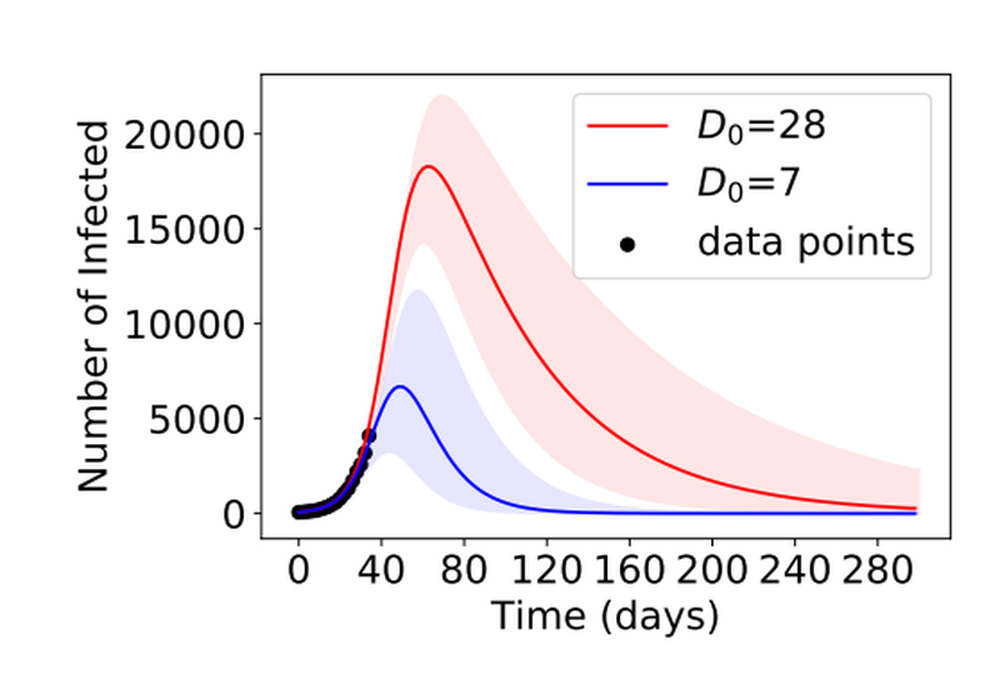
Научная работа опубликована на портале arXiv. В ней описано понятие недостаточной детализации (underspecification) в машинном обучении (machine learning). Авторы указывают на то, как в привычном процессе обучения нейросетевых алгоритмов слишком часто возникают неочевидные поначалу аномалии. В результате обученный таким образом алгоритм будет выдавать непредсказуемые или ошибочные выводы.
По мнению команды специалистов из Google, проблема в следующем. Во время обучения алгоритма на некоем наборе данных искусственный интеллект может сделать не совсем то обобщение, которое считают необходимым или эффективным его создатели. И сам по себе этот факт не является чем-то негативным, наоборот — в этом и есть «сила» нейросетей. Но, тренируя алгоритм, программисты не учитывают и далеко не всегда могут знать, что именно он выбрал в качестве дополнительных критериев. В итоге, классифицируя результаты как точные и неточные, человек обучает ИИ не совсем тому, чему хотел.
Результатом подобного обучения могут стать непредсказуемые ошибки. Например, в эпидемиологии есть математическая модель, описывающая течение эпидемии. Она строится на ключевых параметрах: коэффициенте распространения инфекции (R0) и продолжительности времени, пока заболевший заразен (D). Теоретически даже на ранних стадиях пандемии можно проанализировать эти данные по нескольким случаям и предсказать ее ход. Это крайне важно для властей и медиков, которые будут иметь понимание, когда переполнятся больницы и в какой момент и как нужно реагировать на статистику.
Однако на практике обученный по массивам медицинских данных искусственный интеллект может выдавать разные предсказания. И выбор из них реалистичного — нетривиальная задача. Дело в том, что во время обучения алгоритм будет учитывать множество побочных параметров. Так же делают и люди, но они могут объяснить свои решения, а ИИ — нет. Таким образом, необходимо еще на стадии создания алгоритма и его обучения учитывать все больше параметров. В этот момент появляется второе ключевое ограничение.
Подобных второстепенных параметров может быть огромное количество, и далеко не все из них будут так же важны для человека, как для нейросети. Фактически предсказать только по результату (прогнозу) модели, на основании каких второстепенных факторов была достигнута нужная точность, невозможно. И тем более нельзя сходу оценить, как именно изменится работа алгоритма при других масштабах поступающих данных. Свои соображения авторы описываемой работы наглядно и подробно иллюстрируют четырьмя примерами, в которых ИИ либо традиционно считается более точным, чем человек, либо его использование предполагается наиболее перспективным. Речь о компьютерном зрении, распознавании медицинских изображений и речи , а также медицинских предсказаниях на основе статистики.
Однако не все так ужасно. Авторы работы предлагают методику стрессового тестирования искусственного интеллекта. По их мнению, можно ввести в процесс машинного обучения обязательные стресс-тесты на специально подготовленных данных. Они могут быть нарочно выходящими за рамки моделей или хорошо изученными экстремальными примерами из реальной жизни. В любом случае с их помощью будут сразу обнаружены основные аномалии алгоритма.
Несомненно, озвученные сотрудниками Google идеи не являются революционными и зачастую используются на практике. Но они еще не стали стандартом даже в самых критичных для нас областях применения ИИ. И, конечно, для многих профессионалов вышеописанная работа может выглядеть простой и очевидной. Тем не менее в ней от элементарных моделей до сложнейших симуляций показано влияние недостаточной детализации на результат. Кроме того, авторы работы собрали воедино идеи и выводы из колоссального количества публикаций на смежные темы. Это позволяет назвать ее отличным промежуточным итогом в развитии современных наработок в области ИИ.


 Telegram
 Дзен
 VK
Совместная миссия Европейского космического агентства (ESA) и Японского агентства аэрокосмических исследований (JAXA) по исследованию Меркурия началась в 2018 году. На видео, созданном из кадров с бортовых камер, можно проследить восьмилетний путь зонда BepiColombo.
Оценив, смогут ли запасы водяного льда на Луне обеспечить будущие города с населением от сотен тысяч до миллиона человек, ученые выяснили, что даже при весьма оптимистичных условиях у заселения нашего спутника есть серьезные ограничения.
Авторы нового исследования, возможно, нашли ответ на вопрос, почему естественный отбор не устранил из человеческого генома мутацию, повышающую риск такого тяжелого аутоиммунного заболевания, как волчанка. По-видимому, все дело в эволюционном компромиссе: уязвимость в одной сфере — расплата за преимущество в другой.
Нейросеть OpenAI добилась серьезного прорыва в математике, решив одну из семи «задач тысячелетия». Получат ли США, чьи нейросети опираются на гораздо более мощное «железо», чем у Китая, монополию на конвейер научных открытий? Даст ли это возможности сравнимые с их атомной монополией 80 лет назад?
Совместная миссия Европейского космического агентства (ESA) и Японского агентства аэрокосмических исследований (JAXA) по исследованию Меркурия началась в 2018 году. На видео, созданном из кадров с бортовых камер, можно проследить восьмилетний путь зонда BepiColombo.
Современная космология до недавнего времени опиралась на так называемый космологический принцип, по которому у Вселенной нет какого-то выделенного направления. И наблюдатель в любой ее точке должен видеть однородную в этом смысле картину. Астроном из Северокавказской астрофизической обсерватории показал, что это не так даже для очень древней Вселенной.
Нейросеть OpenAI добилась серьезного прорыва в математике, решив одну из семи «задач тысячелетия». Получат ли США, чьи нейросети опираются на гораздо более мощное «железо», чем у Китая, монополию на конвейер научных открытий? Даст ли это возможности сравнимые с их атомной монополией 80 лет назад?
Сопротивление жителей Европы самой идее употребления насекомых в пищу может иметь эволюционные корни, уходящие вглубь тысячелетий, пришли к выводу авторы нового исследования. Оказалось, предки современных европейцев ели насекомых лишь эпизодически. Кроме того, из-за генетических мутаций они плохо переваривали их экзоскелеты.
После сокращения длины очередей и роста доступности бензина в первую неделю августа ситуация снова ухудшилась. Если с 20 июня по начало августа кризис носил в основном психологический характер, то сейчас ситуация принципиально иная: августовские атаки на НПЗ показали, что меры по усилению их противовоздушной обороны не были достаточно полными. Значит, прогноз автора Naked Science от 19 июля о том, что острая фаза кризиса закончится до конца лета, был частично неверным.

Вы попытались написать запрещенную фразу или вас забанили за частые нарушения.
Понятно
Что-то в вашем комментарии показалось подозрительным, поэтому перед публикацией он пройдет модерацию.
Понятно
Из-за нарушений правил сайта на ваш аккаунт были наложены ограничения. Если это ошибка, напишите нам.
Понятно
Наши фильтры обнаружили в ваших действиях признаки накрутки. Отдохните немного и вернитесь к нам позже.
Понятно


Мы скоро изучим заявку и свяжемся с Вами по указанной почте в случае положительного исхода. Спасибо за интерес к проекту.
Понятно
Последние комментарии