В МФТИ придумали, как поймать ИИ на лжи
В лаборатории фундаментальных исследований искусственного интеллекта МФТИ разработали метод выявления некорректных рассуждений, генерируемых большими языковыми моделями.
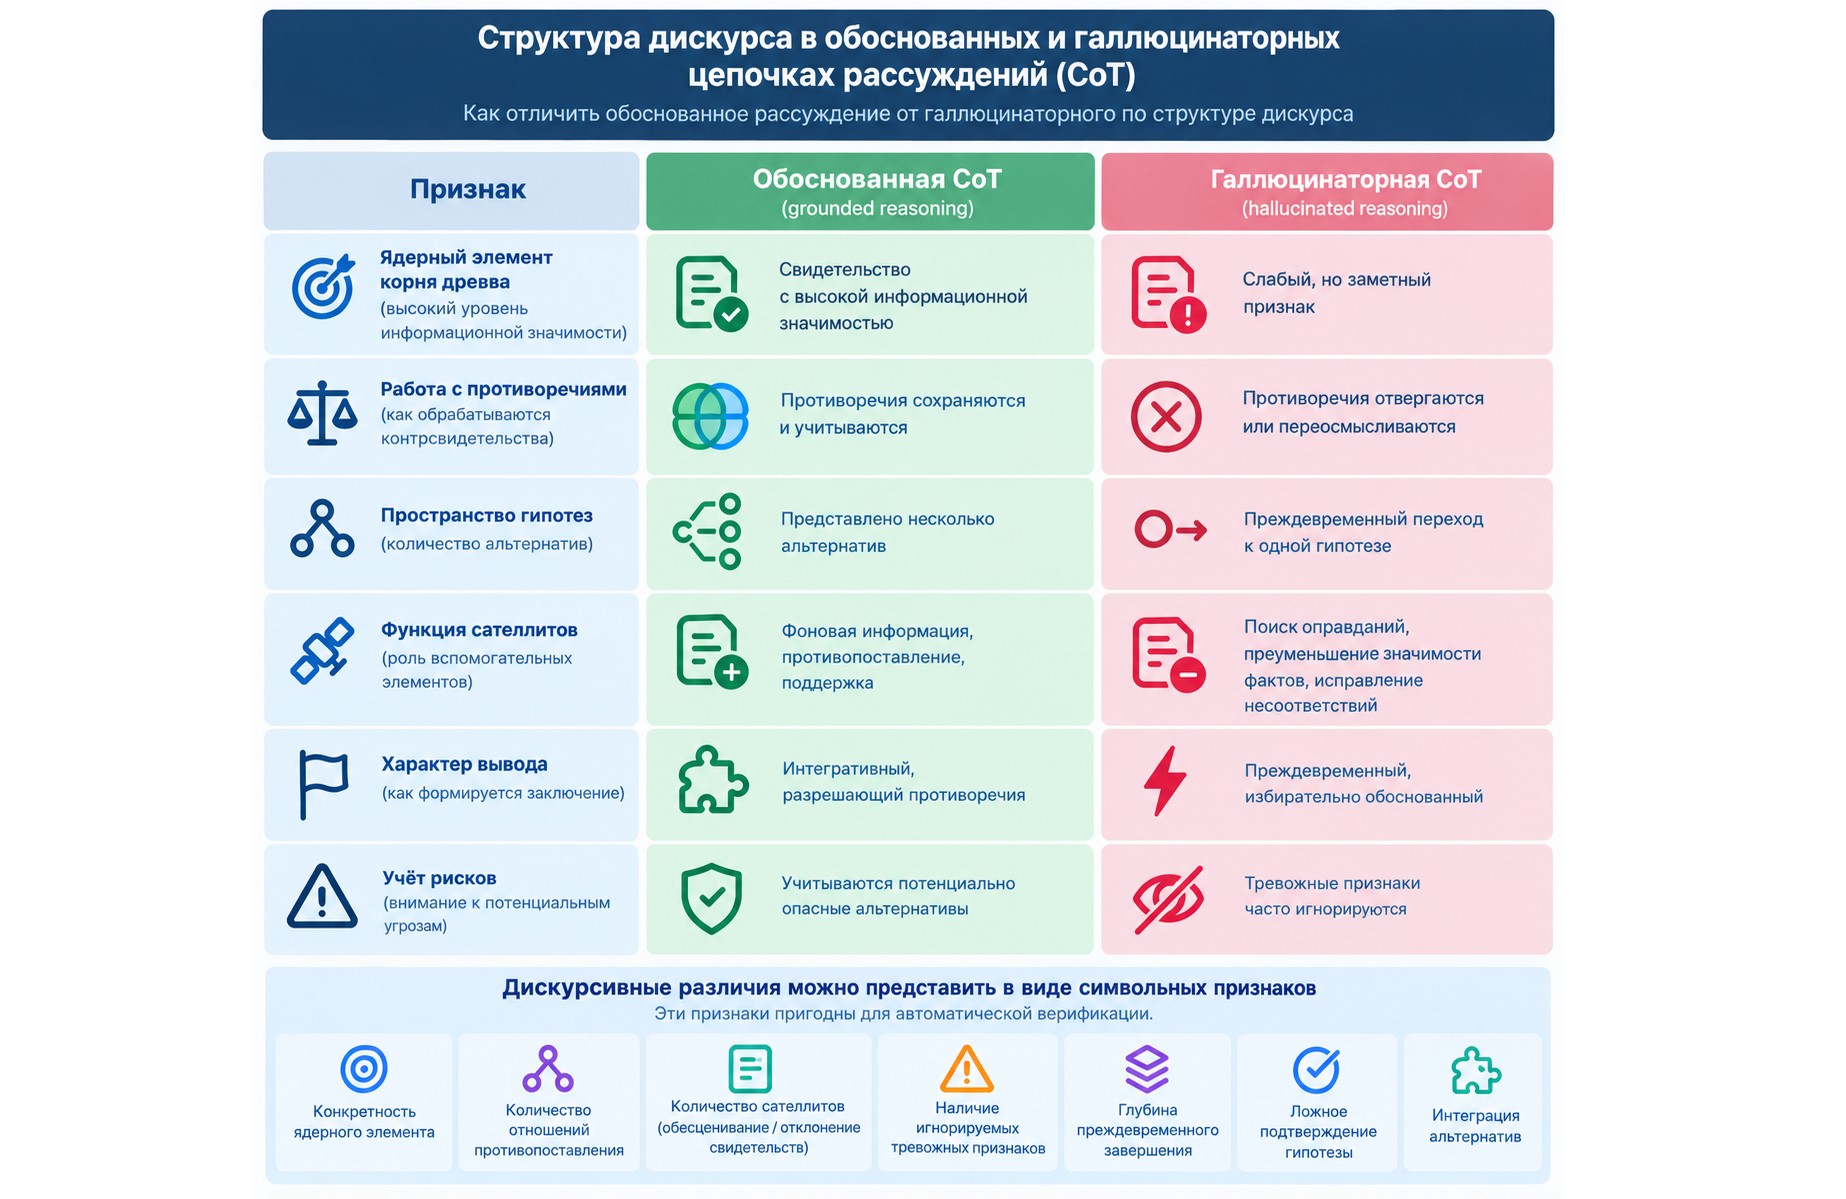
Возможность такой проверки особенно важна в медицине и других областях, где цена ошибки может оказаться высокой. Исследование опубликовано в журнале AI.
«Анализ дискурса не заменяет проверку фактов, но помогает выявлять структурно необоснованные цепочки рассуждений, даже если они изложены бегло и убедительно», — прокомментировал Борис Галицкий, ведущий научный сотрудник лаборатории фундаментальных исследований искусственного интеллекта Института искусственного интеллекта МФТИ.
Мы обращаемся к большим языковым моделям (LLM) как к «консультантам», помогающим нам с решением насущных задач. При этом LLM умеют не просто выдавать готовый ответ, а показывают все промежуточные шаги. Тем самым мы можем оценивать и даже повышать эффективность LLM, поскольку при пошаговом анализе уменьшается риск ошибки, допускаемой системой. На более ранних этапах развития ИИ этот принцип реализовывался за счет промпт-инжинирингового метода цепочки рассуждений (Chain-of-Thought, CoT): пользователь должен был сформулировать запрос так, чтобы LLM расписывала ход своих мыслей, а не переходила к ответу сразу. В современных LLM этот навык активируется автоматически.
Но одна из основных проблем LLM — так называемые галлюцинации. Модели могут выдумывать факты, ссылаться на несуществующие источники и даже генерировать цепочки рассуждений, создающие видимость последовательного обдумывания, но в действительности содержащие логические ошибки. Как обнаружил Борис Галицкий, «галлюцинации связаны не только с фактическим содержанием, но и с дискурсивной организацией рассуждений». В этом контексте становится актуальной задача систематического изучения закономерностей в цепочках рассуждений, генерируемых большими языковыми моделями.
«Большинство существующих исследований галлюцинаций сосредоточено на фактических неточностях, вымышленных ссылках, неподтвержденных утверждениях или неправильных итоговых ответах. Между тем надежность диагностического или аналитического вывода зависит не только от достоверности отдельных фактов, но и от того, как в процессе рассуждения отбираются свидетельства, определяется их значимость, сопоставляются альтернативы и объединяются полученные данные», — говорит Борис Галицкий.
Предлагаемый метод проверки основан на том, что структуру рассуждения можно рассматривать как индикатор наличия галлюцинаций. Анализируя цепочки шагов, модели смогут научиться различать обоснованные рассуждения от галлюцинаторных.
Для проверки этой идеи была составлена выборка из 1000 сгенерированных жалоб пациентов на симптомы аутоиммунных и ревматологических заболеваний: ревматоидного артрита, системной красной волчанки, анкилозирующего спондилита и других. При этом жалобы намеренно сформулировались неоднозначно, чтобы LLM не смогла бы поставить диагноз по одному ключевому слову.
Для каждой жалобы были подготовлены два варианта рассуждения, ведущего к диагнозу: обоснованное и галлюцинаторное. Обоснованное рассуждение опиралось на самые значимые симптомы, учитывало противоречащие признаки и сравнивало возможные диагнозы. Второй вариант содержал одну из шести типичных ошибок.
Затем для наглядности каждое рассуждение раскладывалось в схему. Текст делился на короткие смысловые фрагменты, и каждому фрагменту присваивалась роль: главное утверждение, подтверждающий довод, противоречащий довод, отбрасывание неудобного факта, вывод. Такая схема отображает структуру рассуждения: что в нем главное, что второстепенное, учтены ли противоречия и в какой момент принято решение.
При сопоставлении схем обоснованных и галлюцинаторных рассуждений были выявлены существенные различия. В обоснованных рассуждениях свидетельства с высокой информативной значимостью встречались в 79% случаев, а в галлюцинаторных — только в 15%. Этап, на котором разные факты сводятся воедино перед выводом, присутствовал в 79% обоснованных рассуждений и лишь в 16% галлюцинаторных. Также в среднем галлюцинаторные рассуждения короче и проще по структуре: модель переходила к выводу, минуя сопоставление данных.
На следующем этапе классификатор обучили отличать обоснованные рассуждения от галлюцинаторных, исходя только из их структуры. Классификатор верно определял тип рассуждения примерно в 81% случаев, работая только со схемами без содержания.
Затем структурный сигнал объединили с другими сигналами, указывающими, насколько меняется рассуждение при повторной генерации (геометрический сигнал), и наличие более сильных диагностических гипотез (абдуктивный сигнал). При соединении трех этих компонентов классификатор правильно распознавал галлюцинаторные рассуждения в 84% случае, а без структурного сигнала — только в 72%. Последующие эксперименты показали, что ни один отдельно взятый сигнал не повторяет максимального результата: они дополняют друг друга.
Таким образом структурный анализ привносит важное дополнение в исследование галлюцинаций больших языковых моделей, но не сможет заменить проверку фактов.
«Нам удалось получить три важных результата. Во-первых, мы предлагаем набор данных для изучения характеристик галлюцинаторных диагностических рассуждений на уровне дискурса. Во-вторых, мы выявляем набор структурных дискурсивных признаков, позволяющих отличать обоснованные объяснения по цепочке мыслей от галлюцинаторных. В-третьих, мы демонстрируем, как эти признаки могут применяться для интерпретируемого обнаружения галлюцинаций и верификации рассуждений, способствуя разработке более надежных и объяснимых систем на основе больших языковых моделей», — подчеркнул Борис Галицкий.
Лаборатория фундаментальных исследований искусственного интеллекта — структурное подразделение Института искусственного интеллекта МФТИ. Основные направления деятельности лаборатории связаны с алгоритмами оптимизации в машинном обучении, развитием мультиагентных систем, генеративных и больших языковых моделей и проч.


 Telegram
 Дзен
 VK