


Этот пост добавлен читателем Naked Science в раздел «Сообщество». Узнайте как это сделать по ссылке.

Чат-боты реже исправляли ошибки, когда пользователи ругались
После первого замечания без ругани чат-бот исправлял ответ со следующей попытки в 35% случаев. Если в замечании были брань или оскорбления, доля исправлений составляла 24%. Такую разницу компания Searchable обнаружила в переписке американских пользователей с ChatGPT, Gemini и Claude.
Searchable изучила более восьми миллионов сообщений, которые участники исследования из США написали или надиктовали чат-ботам с 21 сентября 2025 года по 20 сентября 2026-го. Все участники согласились на сбор данных, переписки обезличили. При подсчете ругательств аналитики исключили длинные вставки из документов и кода.
Из переписок отобрали разговоры, в которых пользователь попросил что-то исправить. Даже резкое «это неверно» считалось обычным замечанием, если в нем не было брани или оскорблений. Исход оценивала отдельная ИИ-модель. Она читала диалог с момента жалобы до последней реплики и определяла, получил ли человек то, о чем просил.
Примерно четыре из пяти грубых сообщений в адрес бота содержали жалобу. В остальных пользователи шутили, поддразнивали бота или пытались его спровоцировать. Самым частым поводом для недовольства стала пропущенная инструкция.
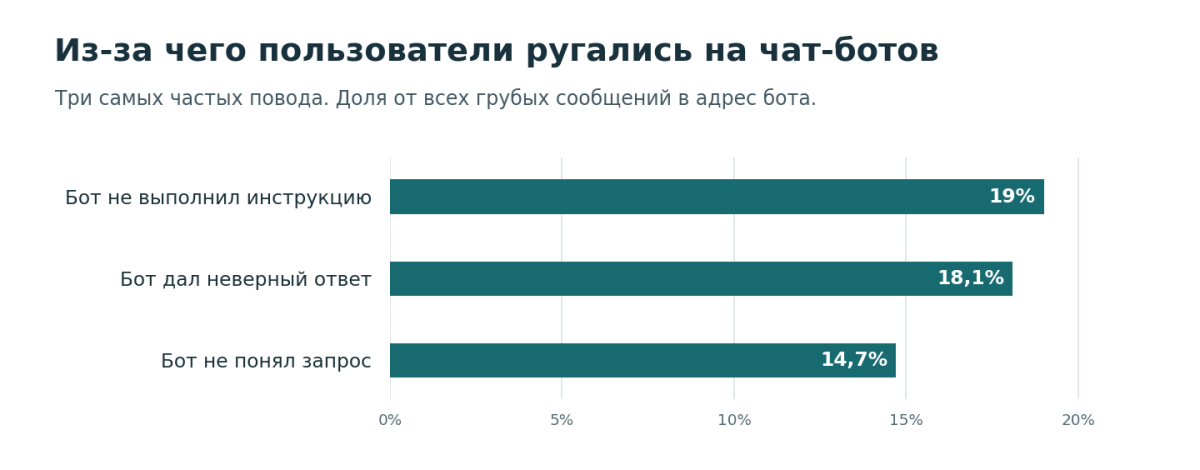
Что происходило после замечания
К концу диалога бот исправил ответ в 41% случаев после замечания без ругани и в 31% после жалобы с бранью. Если проблему все же удавалось решить, на это уходило примерно одинаковое число ответов в обеих группах.
Участники нередко ругались, когда разговор уже не ладился. Если взять все жалобы с бранью, в 73% случаев человек уже жаловался или ругался в том же чате. Среди замечаний без брани таких было 43%. По этим перепискам нельзя установить, получил бы человек другой ответ, если бы сменил тон.
В отдельном эксперименте исследователи из Университета штата Пенсильвания задали четырем моделям одни и те же 570 вопросов с вариантами ответа, меняя тон запроса. GPT-5 nano ответила верно в среднем на 82% вопросов при нейтральной формулировке и на 71% при угрозах. У Gemini 2.5 Flash та же замена немного повысила точность — с 89,4 до 90,7%.
Нашли опечатку? Выделите фрагмент и нажмите Ctrl (Cmd) + Enter.


 Telegram
 Дзен
 VK
Предстоящие мероприятия
На южном полюсе Луны есть впадина диаметром более двух тысяч километров — крупнейший бесспорный след падения небесного тела в Солнечной системе. Недавно китайский автомат впервые в истории доставил оттуда пробу грунта. Теперь китайские ученые на ее основе разобрались в формировании этого ударного бассейна.
Под Новосибирском в наукограде Кольцово создан суперсовременный научный объект – источник синхротронного излучения, который называется Центр коллективного пользования «Сибирский кольцевой источник фотонов» или сокращенно ЦКП «СКИФ». Установка реально большая, сложная, перспективная и давно ожидаемая исследовательским сообществом страны, поэтому внимания со стороны СМИ хватает. Желающие могут погуглить и почитать. Многие, кому интересно, что такое «источник синхротронного излучения», так и делают, читают и оставляют комментарии (куда же без них!). В этой статье на Naked Science директор ЦКП «СКИФ» академик РАН Евгений Левичев попытался ответить на волнующие читателей вопросы и рассказать, что такое СКИФ, и зачем мы его построили.
Скорость развития собаки в первые годы жизни оказалась намного выше, чем у человека, но дальше процессы ее старения существенно замедляются. Даже скорость взросления и угасания отдельных подсистем организма у этих животных серьезно неодинаковая, из-за чего расхожее представление «один собачий год равен семи человеческим» дважды неверно.
Скорость развития собаки в первые годы жизни оказалась намного выше, чем у человека, но дальше процессы ее старения существенно замедляются. Даже скорость взросления и угасания отдельных подсистем организма у этих животных серьезно неодинаковая, из-за чего расхожее представление «один собачий год равен семи человеческим» дважды неверно.
На южном полюсе Луны есть впадина диаметром более двух тысяч километров — крупнейший бесспорный след падения небесного тела в Солнечной системе. Недавно китайский автомат впервые в истории доставил оттуда пробу грунта. Теперь китайские ученые на ее основе разобрались в формировании этого ударного бассейна.
Сегодня, 15 ноября 2026 года, люди впервые вернули из космоса вторую ступень космической ракеты. Причем сделали это с первой попытки и весьма гладко. А это значит, что полностью многоразовые ракеты из научной фантастики становятся реальностью: человечество вступает в эру принципиально новых возможностей в космосе. Разбираемся в технических последствиях происходящего — и для планеты в целом, и конкретно для нашей страны.
Физики изучили уравнения Эйнштейна в форме, похожей на уравнения плазмы, и построили математическую теорию «гравитационного пересоединения». В рамках нее по аналогии с разрывом и слипанием магнитных силовых линий в плазме гравитационные «листы» пространства-времени тоже могли бы разрываться и слипаться, передавая энергию из поля в вещество.
Спутниковый анализ позволил составить карту истощения подземных вод по всей планете. Оказалось, в наибольшей степени сокращение запасов происходит не от уменьшения объема осадков, а там, где подземные воды активнее всего используют для орошаемого земледелия, важного для обеспечения продовольствием миллиардов людей.
Скорость развития собаки в первые годы жизни оказалась намного выше, чем у человека, но дальше процессы ее старения существенно замедляются. Даже скорость взросления и угасания отдельных подсистем организма у этих животных серьезно неодинаковая, из-за чего расхожее представление «один собачий год равен семи человеческим» дважды неверно.
[miniorange_social_login]
Подтвердить?

Не получилось опубликовать!
Вы попытались написать запрещенную фразу или вас забанили за частые нарушения.
Понятно
Комментарий на проверке
Что-то в вашем комментарии показалось подозрительным, поэтому перед публикацией он пройдет модерацию.
Понятно
Аккаунт заблокирован!
Из-за нарушений правил сайта на ваш аккаунт были наложены ограничения. Если это ошибка, напишите нам.
Понятно
Что-то пошло не так!
Наши фильтры обнаружили в ваших действиях признаки накрутки. Отдохните немного и вернитесь к нам позже.
ПонятноЛучшие материалы

Войти
Вконтакте

По e-mail

Google

Яндекс ID
Ваша заявка получена
Мы скоро изучим заявку и свяжемся с Вами по указанной почте в случае положительного исхода. Спасибо за интерес к проекту.
Понятно