В МФТИ учли «память» данных при поиске равновесия
Физтехи исследовали алгоритм поиска равновесия, например баланса между участниками транспортных потоков с разными целями. Математики показали, как на точность работы алгоритма влияет наличие «памяти» у данных. Это означает, что очередное наблюдение связано с предыдущими.
Характерным примером задачи равновесия является задача о распределении транспортных потоков. Она заключается в том, чтобы найти такое состояние, при котором отдельному водителю невыгодно менять маршрут, если остальные сохраняют свои. Подобные задачи можно описывать и решать с помощью вариационных неравенств.
При поиске решения алгоритм может получать сведения о задаче небольшими порциями, например обрабатывать случайно выбранную часть данных. На каждом шаге он строит приближенную оценку направления дальнейшего движения. Случайное отклонение этой оценки от точного значения называют шумом. В теории часто предполагают, что источник шума на очередном шаге не зависит от предыдущих наблюдений. В реальности же такая независимость может нарушаться, так как текущее состояние системы влияет на следующее.
Исследователи описали эту связь с помощью марковской цепи. В такой модели вероятности следующего состояния определяются текущим. Это значит, что при известном текущем состоянии более ранняя история не добавляет новых сведений для прогноза.
Однако при этом состояния оказываются связанными друг с другом таким образом, что какая-то информация о прошлых состояниях сохраняется в текущих. Длительность этой «памяти» характеризует время перемешивания — число шагов, за которое влияние начального состояния становится достаточно малым. Этот параметр измеряет, как быстро марковская цепь забывает исходное состояние.
Поиск равновесия требует учитывать взаимное влияние участников или переменных. В таких задачах последовательные попытки улучшить текущее положение могут приводить к колебаниям вокруг решения. Чтобы скорректировать направление движения, алгоритм использует дополнительный пробный шаг. Сначала он вычисляет промежуточное приближение, затем заново оценивает направление в этой точке и по уточненной оценке делает основной шаг из исходной точки.
Особенность проделанной учеными работы состояла в определении более мягкого требования к величине случайной ошибки. В предлагаемом методе достаточно ограничить ее в самой точке решения: единой границы для всего пространства поиска не требуется. При выполнении остальных условий это позволяет исследовать задачи, в которых шум вдали от решения может быть сильнее.
Чтобы оценить точность метода и число шагов, достаточное для приближения к равновесию, исследователи задали правила, по которым вычисляется направление шага.
Они оценили, сколько шагов достаточно для достижения заданной точности и как выбрать их размер. Часть этой оценки, связанная со случайной ошибкой, в теории зависит от квадрата времени перемешивания: чем дольше данные сохраняют «память», тем больше шагов необходимо для достижения той же точности. Часть оценки, не связанная с шумом, такой зависимости не содержит.
Владимир Солодкин, ведущий инженер лаборатории фундаментальных исследований искусственного интеллекта ФПМИ МФТИ, так объяснил суть работы: «Зависимые наблюдения нельзя автоматически считать новой независимой информацией на каждом шаге. Время перемешивания позволяет учесть, насколько долго сохраняется эта зависимость. Мы включили его в оценку сходимости и получили условия, при которых экстраградиентный метод продолжает приближаться к решению».
В компьютерном эксперименте математики проверили метод на тестовой задаче, которую можно представить как игру двух участников с противоположными интересами. Каждый выбирает значения своих переменных, а заданная формула определяет условный выигрыш одного участника за счет другого. Один стремится увеличить этот выигрыш, второй — уменьшить. Алгоритм ищет такое сочетание значений, при котором никто не может улучшить свой результат, меняя только собственные переменные. Такую задачу называют седловой.
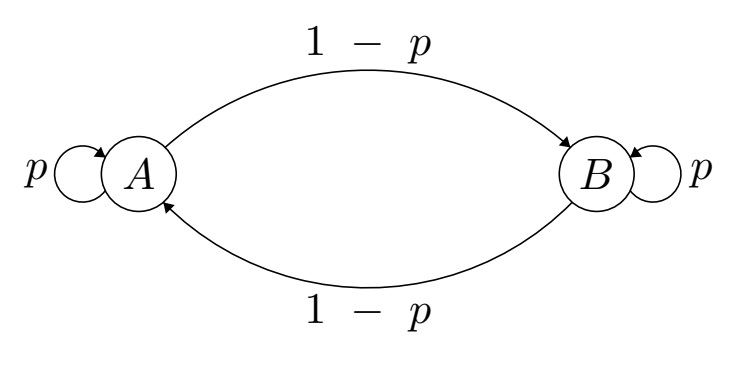
Случайные ошибки задавали с помощью марковской цепи с двумя состояниями, меняя вероятность остаться в текущем состоянии.
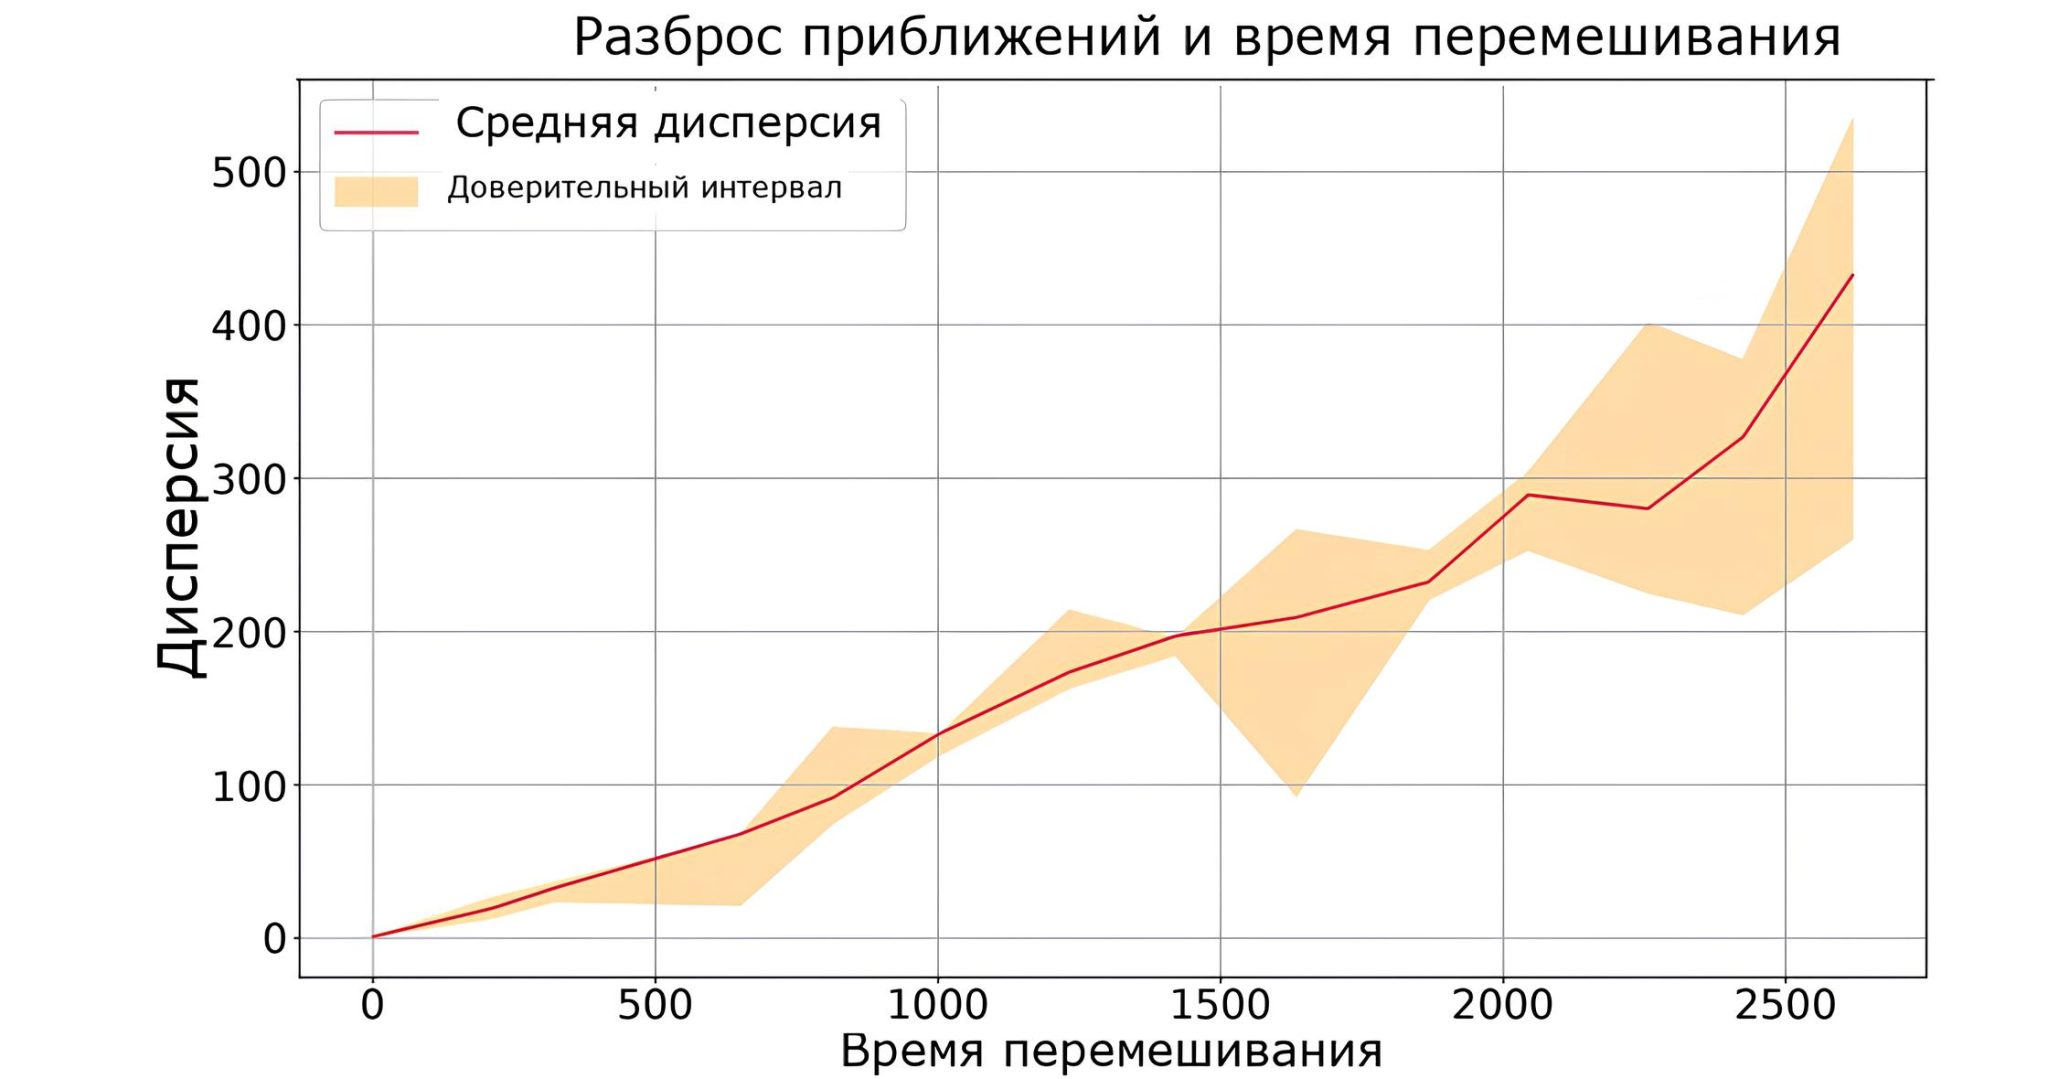
В каждом запуске алгоритм вычислял последовательность приближений к решению. Ученые измеряли их разброс относительно среднего значения за запуск, а затем усредняли показатель по запускам. Усредненная дисперсия (количественная мера этого разброса) росла примерно пропорционально времени перемешивания. А в теории она зависит от квадрата времени. То есть в дальнейшем нужно либо уточнить теоретическое доказательство или изменить постановку эксперимента, чтобы точнее описать влияние «памяти» данных на работу алгоритма.
Полученные формулы помогают настроить алгоритм: выбрать, насколько сильно корректировать приближение к решению на каждом шаге, и оценить, как много нужно проделать вычислений чтобы достичь нужной точности.
Работа опубликована в журнале Optimization Methods and Software. Исследование выполнено при поддержке Российского научного фонда, проект №25-71-00058.


 Telegram
 Дзен
 VK